Engenharia de dados
Pipeline de crédito
Validar antes de publicar.
20 regras de qualidade
Projeto próprio de engenharia de dados
Job serverless com seis tarefas e mais de 40 testes automatizados na alternativa local. Não representa uma operação de concessão de crédito.
A DECISÃO QUE IMPORTA
Bloquear a publicação quando os dados falham
Uma execução concluída não basta. As regras de qualidade impedem que dados inválidos sigam para análises e modelos e deixam registro na auditoria.
EXPERIMENTE UMA DECISÃO DO PROJETO
Você publicaria estes dados?
Altere a amostra e execute a validação. A publicação só é liberada se todas as verificações desta demonstração passarem.
Simulação local com dados fictícios e três verificações simplificadas. Não executa o Databricks nem reproduz as 20 regras do projeto.
| Cliente | Renda mensal |
|---|---|
| Cliente 101 | R$ 3.200,00 |
| Cliente 102 | R$ 4.500,00 |
| Cliente 103 | R$ 2.800,00 |
Ative o JavaScript para experimentar. A explicação do projeto está disponível abaixo.
O desafio
Análises de crédito dependem de uma base consistente. Registros inválidos não devem seguir silenciosamente para os relatórios e modelos.
Minha contribuição
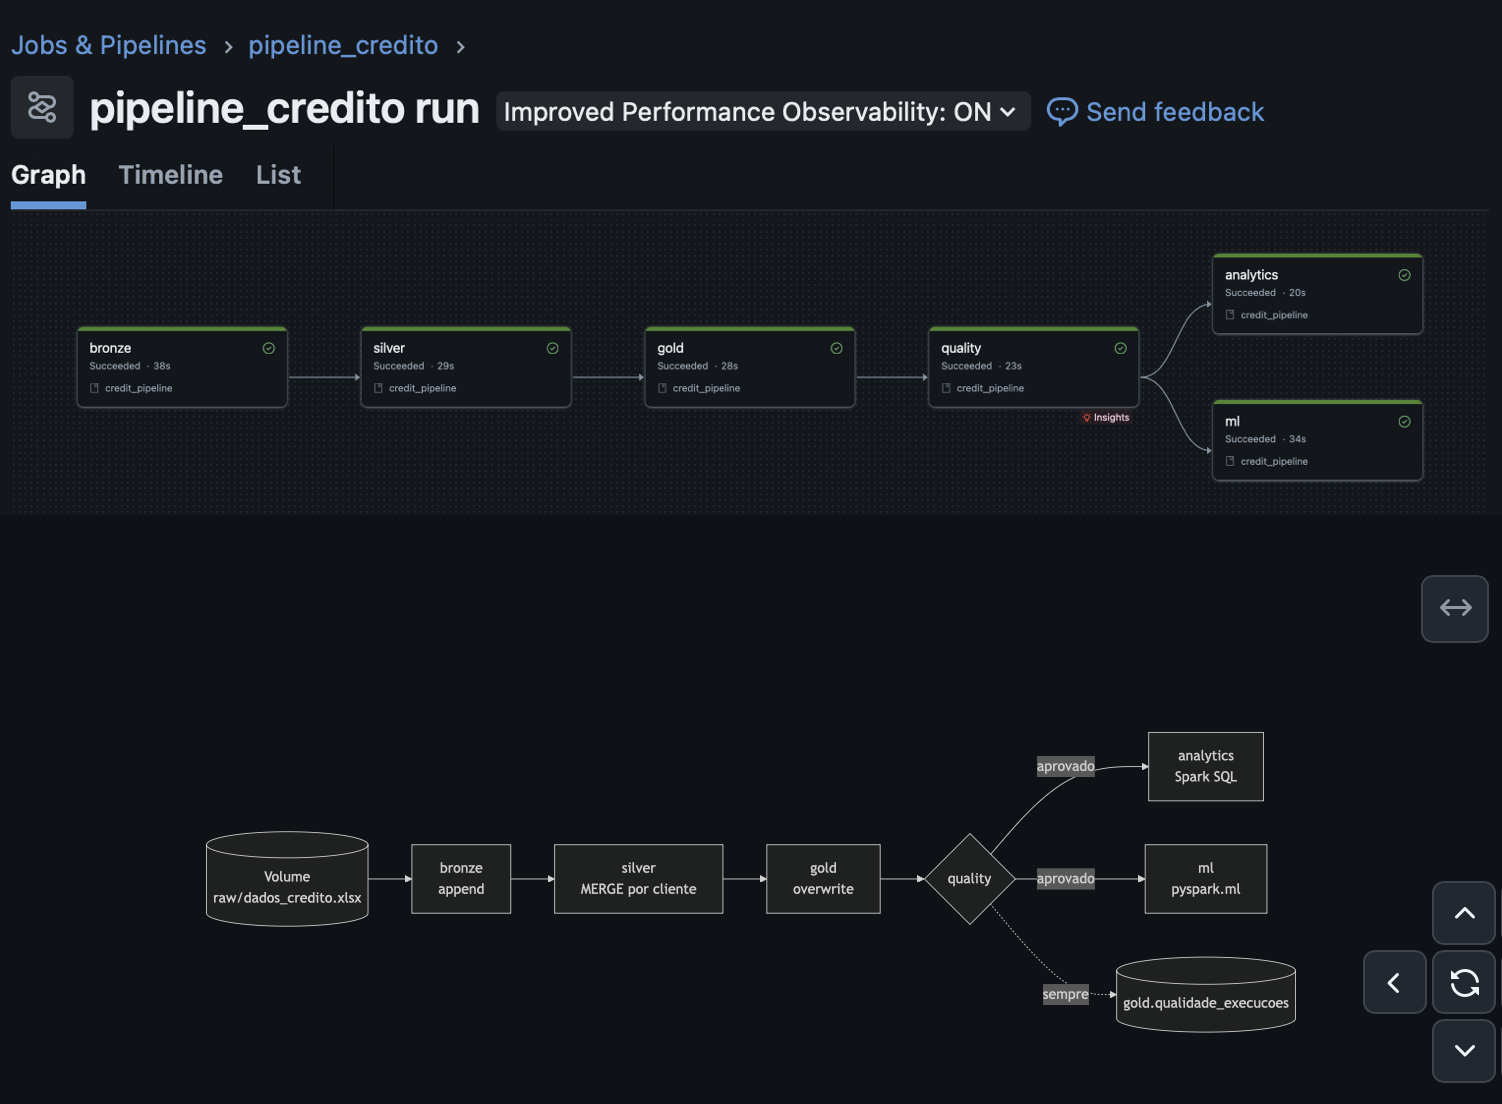
Construí um pipeline no Databricks com etapas de ingestão, tratamento e disponibilização dos dados. Incluí atualizações incrementais, auditoria das execuções e uma barreira de qualidade com 20 regras.
O resultado
Dados que falham na validação bloqueiam a publicação e as tarefas seguintes. A mesma lógica também roda localmente, com mais de 40 testes automatizados.
Projeto próprio de engenharia de dados. Não representa uma operação de concessão de crédito ou um resultado financeiro em clientes.
Explorar os detalhes técnicos
Arquitetura medalhão, job serverless de 6 tarefas, Databricks Asset Bundles, Delta Lake e Unity Catalog. Bronze com histórico de ingestão e Silver com MERGE INTO por cliente. Regras de qualidade em uma única passada, cache da Gold e ajuste das partições de shuffle. Alternativa local com Parquet, PostgreSQL, Airflow e CI no GitHub Actions.