Ingeniería de datos
Pipeline de crédito
Validar antes de publicar.
20 reglas de calidad
Proyecto propio de ingeniería de datos
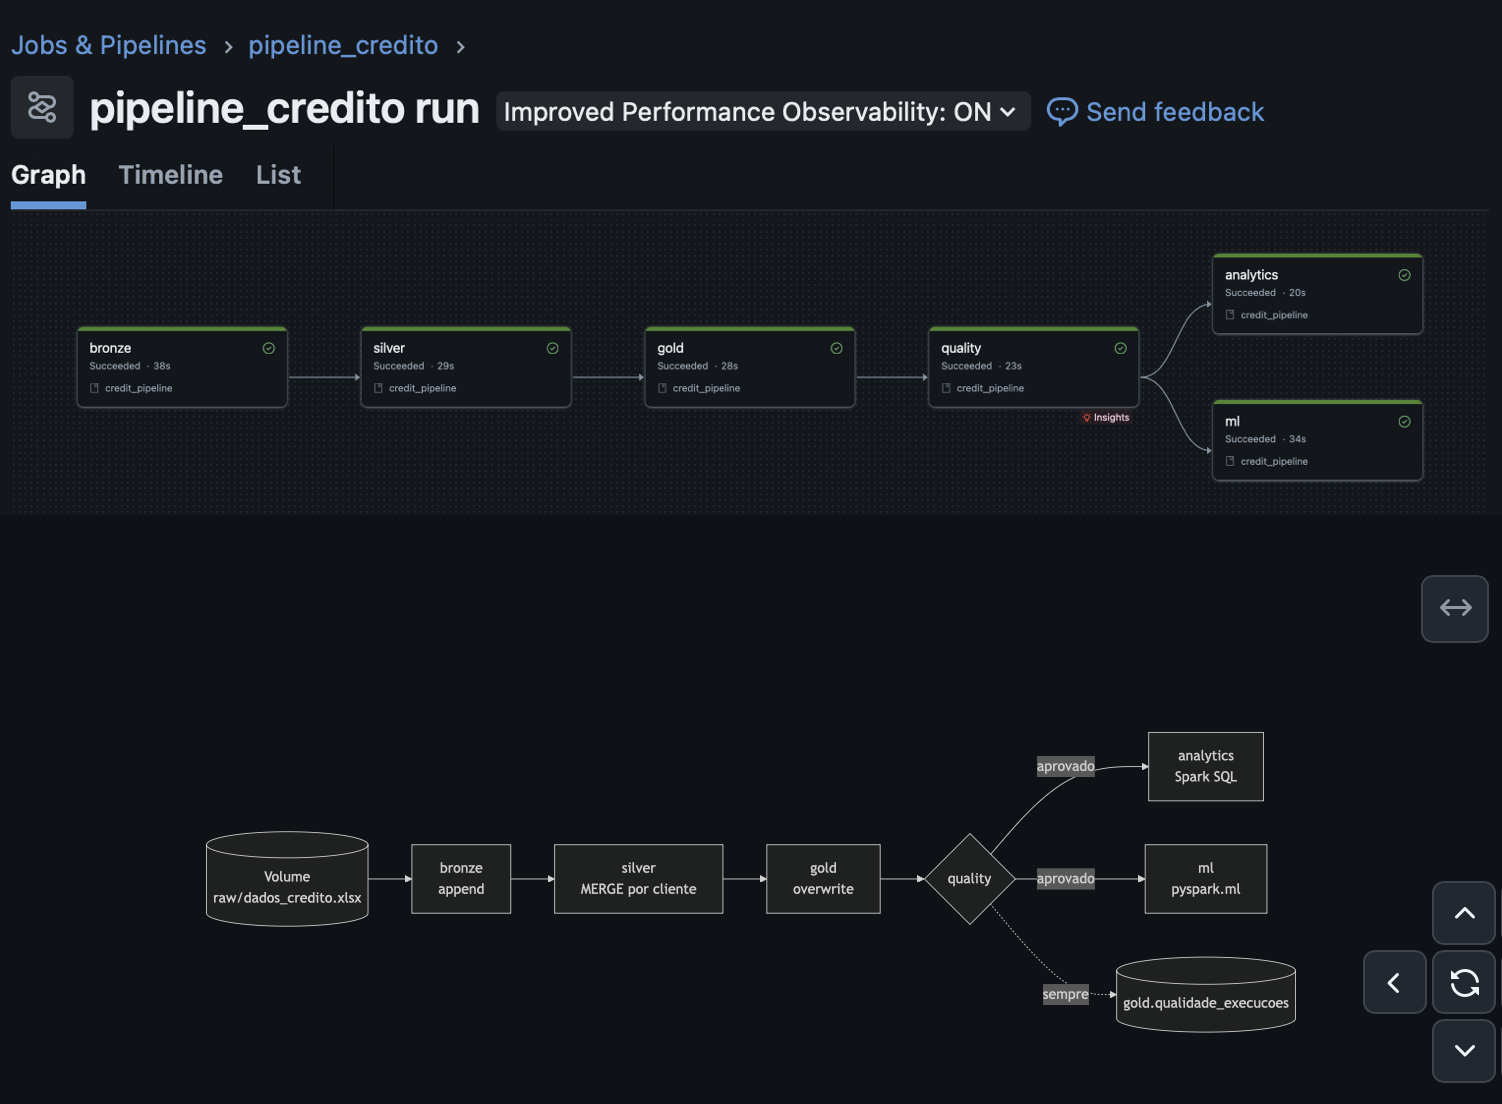
Job serverless con seis tareas y más de 40 pruebas automatizadas en la alternativa local. No representa una operación de concesión de crédito.
LA DECISIÓN QUE IMPORTA
Bloquear la publicación cuando los datos fallan
Una ejecución terminada no basta. Las reglas de calidad impiden que los datos inválidos lleguen a los análisis y modelos, y dejan un registro de auditoría.
PRUEBA UNA DECISIÓN DEL PROYECTO
¿Publicarías estos datos?
Modifica la muestra y ejecuta la validación. La publicación solo se permite si todas las comprobaciones de esta demostración se superan.
Simulación local con datos ficticios y tres comprobaciones simplificadas. No ejecuta Databricks ni reproduce las 20 reglas del proyecto.
| Cliente | Ingresos mensuales |
|---|---|
| Cliente 101 | 3200,00 BRL |
| Cliente 102 | 4500,00 BRL |
| Cliente 103 | 2800,00 BRL |
Activa JavaScript para probarlo. La explicación del proyecto está disponible a continuación.
El reto
Los análisis de crédito dependen de una base consistente. Los registros inválidos no deben pasar silenciosamente a los informes y modelos.
Mi contribución
Construí un pipeline en Databricks con etapas de ingesta, tratamiento y publicación de datos. Incluí actualizaciones incrementales, auditoría de ejecuciones y controles de calidad con 20 reglas.
El resultado
Los datos que fallan en la validación bloquean la publicación y las tareas siguientes. La misma lógica también se ejecuta localmente, con más de 40 pruebas automatizadas.
Proyecto propio de ingeniería de datos. No representa una operación de concesión de crédito ni un resultado financiero para clientes.
Explorar los detalles técnicos
Arquitectura medallón, job serverless de seis tareas, Databricks Asset Bundles, Delta Lake y Unity Catalog. Bronze con historial de ingesta y Silver con MERGE INTO por cliente. Reglas de calidad en una sola pasada, caché de Gold y ajuste de las particiones de shuffle. Alternativa local con Parquet, PostgreSQL, Airflow y CI en GitHub Actions.